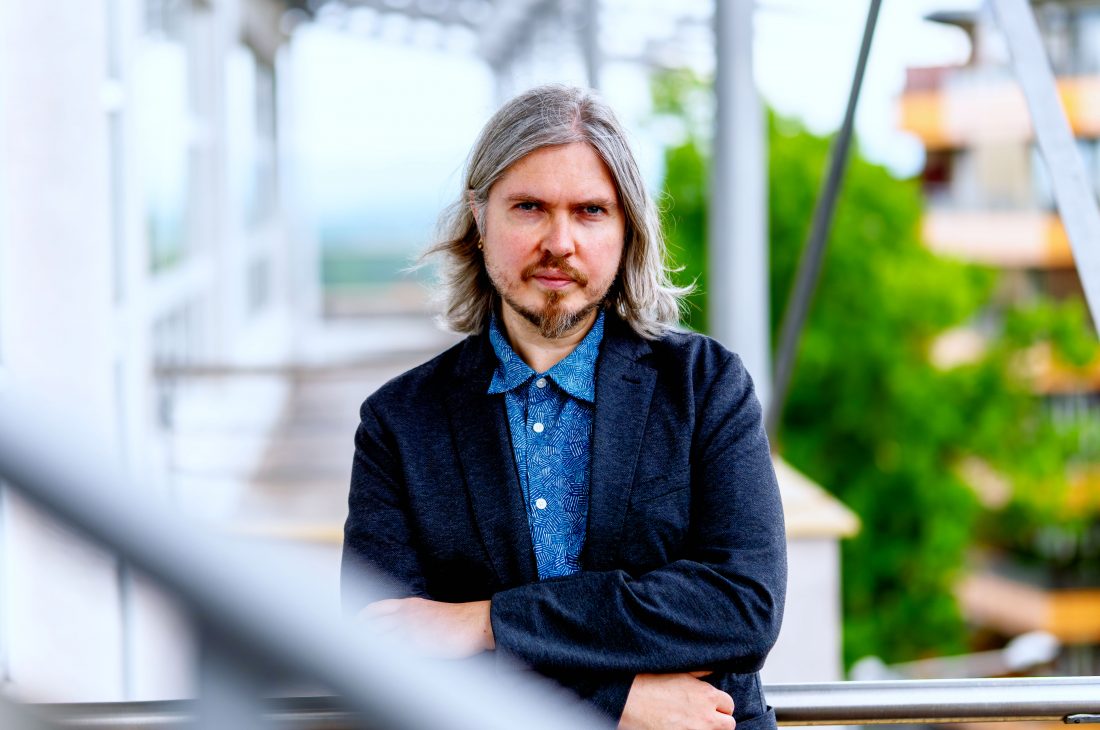
Z DNA našich předků dokáže se svým týmem zrekonstruovat migrace i mísení dávných populací. Archeogenetik Přírodovědecké fakulty Pavel Flegontov teď za svůj výzkum získal Cenu předsedy Grantové agentury ČR (GA ČR). Přinášíme vám krátký rozhovor s oceněným vědcem Ostravské univerzity.
 7 min.

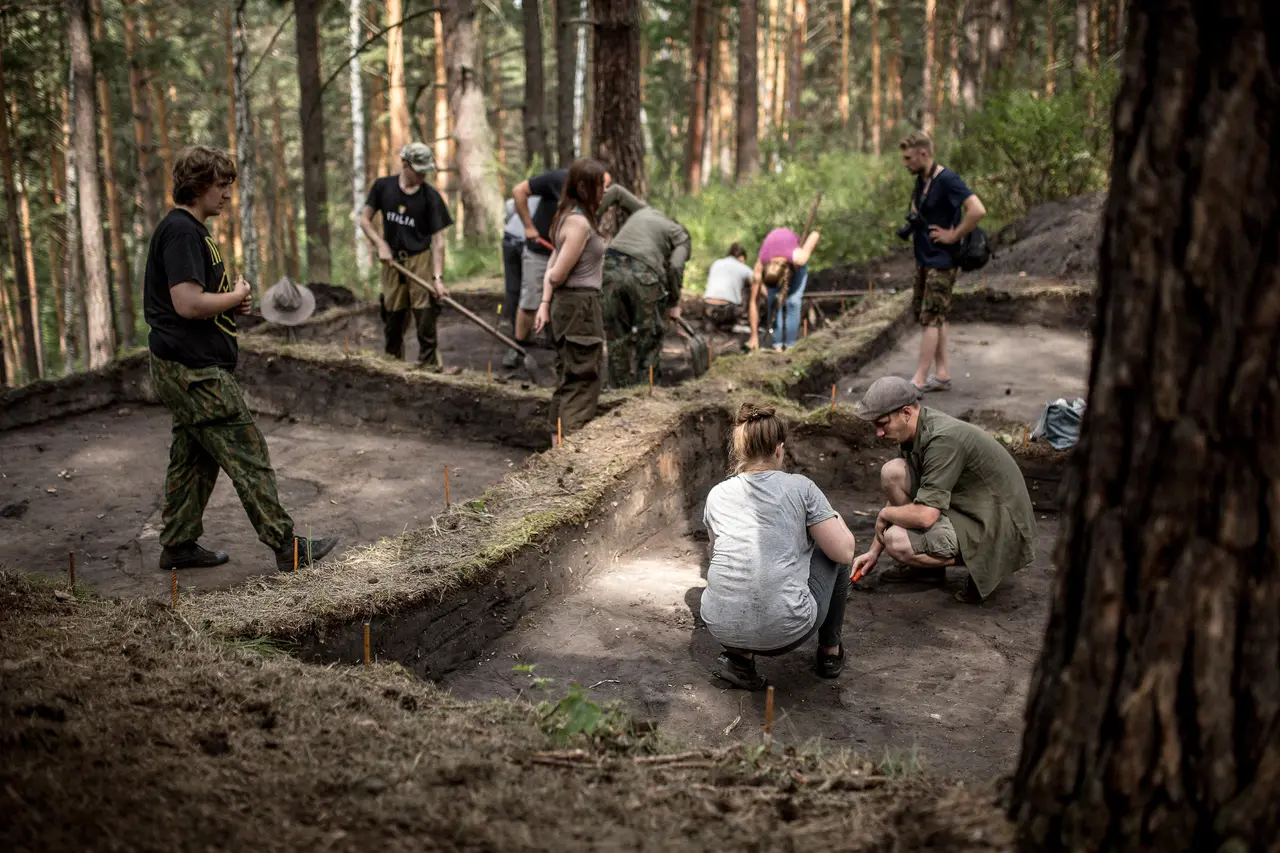
Začíná v laboratoři. DNA se nejčastěji získává z kosti nebo ze zubů. Následně se nasekvenuje a získané úseky DNA se porovnávají s referenčním lidským genomem.
Výsledkem je obrovská datová matice tvořená jednotlivci a jejich genetickými variantami. Protože jde o data s extrémně vysokým počtem dimenzí, používáme vizualizační metody, které nám umožňují identifikovat strukturu populace a genetické podobnosti.
Samotná vizualizace ale historii populace neukazuje. K tomu potřebujeme modely mísení a migrace. Důležité jsou také delší úseky DNA zděděné od společných předků.
Nakonec genetické důkazy propojujeme s archeologickými a chronologickými poznatky. Rekonstruujeme ale minulost reprezentovanou získanými vzorky, nikoli historii celé dávné populace.
Je to překvapivě obtížné. Některé metody používané při studiu starobylé lidské DNA mohou vytvořit výsledky, které na první pohled vypadají přesvědčivě, ale ve skutečnosti jsou chybné.
Dobře to ilustruje jedna z našich simulací publikovaných v časopise Genetics. V simulovaném scénáři zdědila mladší populace genetickou informaci od starší. Běžně používaný analytický postup však starší populaci nesprávně vymodeloval jako směs, do které naopak přispěla tato mladší populace. Vytvořil věrohodně vyhlížející výsledek, ale genetický tok, který za ním stál, šel v reálu opačným směrem.
Zavádějící je i to, že tento nesprávný scénář zdánlivě podpořily i další dvě běžně používané metody. Shoda tří různých přístupů tak vytvořila falešný pocit jistoty. Pokud model projde statistickým testem, neznamená to automaticky, že je správný; znamená to pouze, že nebyl zamítnut.
Nemůžeme porovnat výsledek s tím, co se skutečně stalo před tisícovkami let. Vytváříme realistické prostředí, ve kterém můžeme testovat, jak se genetické metody chovají.
V našich simulacích například malé populace žijí v určité oblasti, v každé generaci si vyměňují migranty nebo mohou být odděleny překážkami různé propustnosti. Občas mezi nimi může dojít i k dálkovému migračnímu skoku.
Výhodou je, že u takto vytvořených genetických dat víme, jaká přesná historie stála za jejich vznikem. Můžeme tedy testovat, zda ji používané metody dokážou skutečně rekonstruovat.
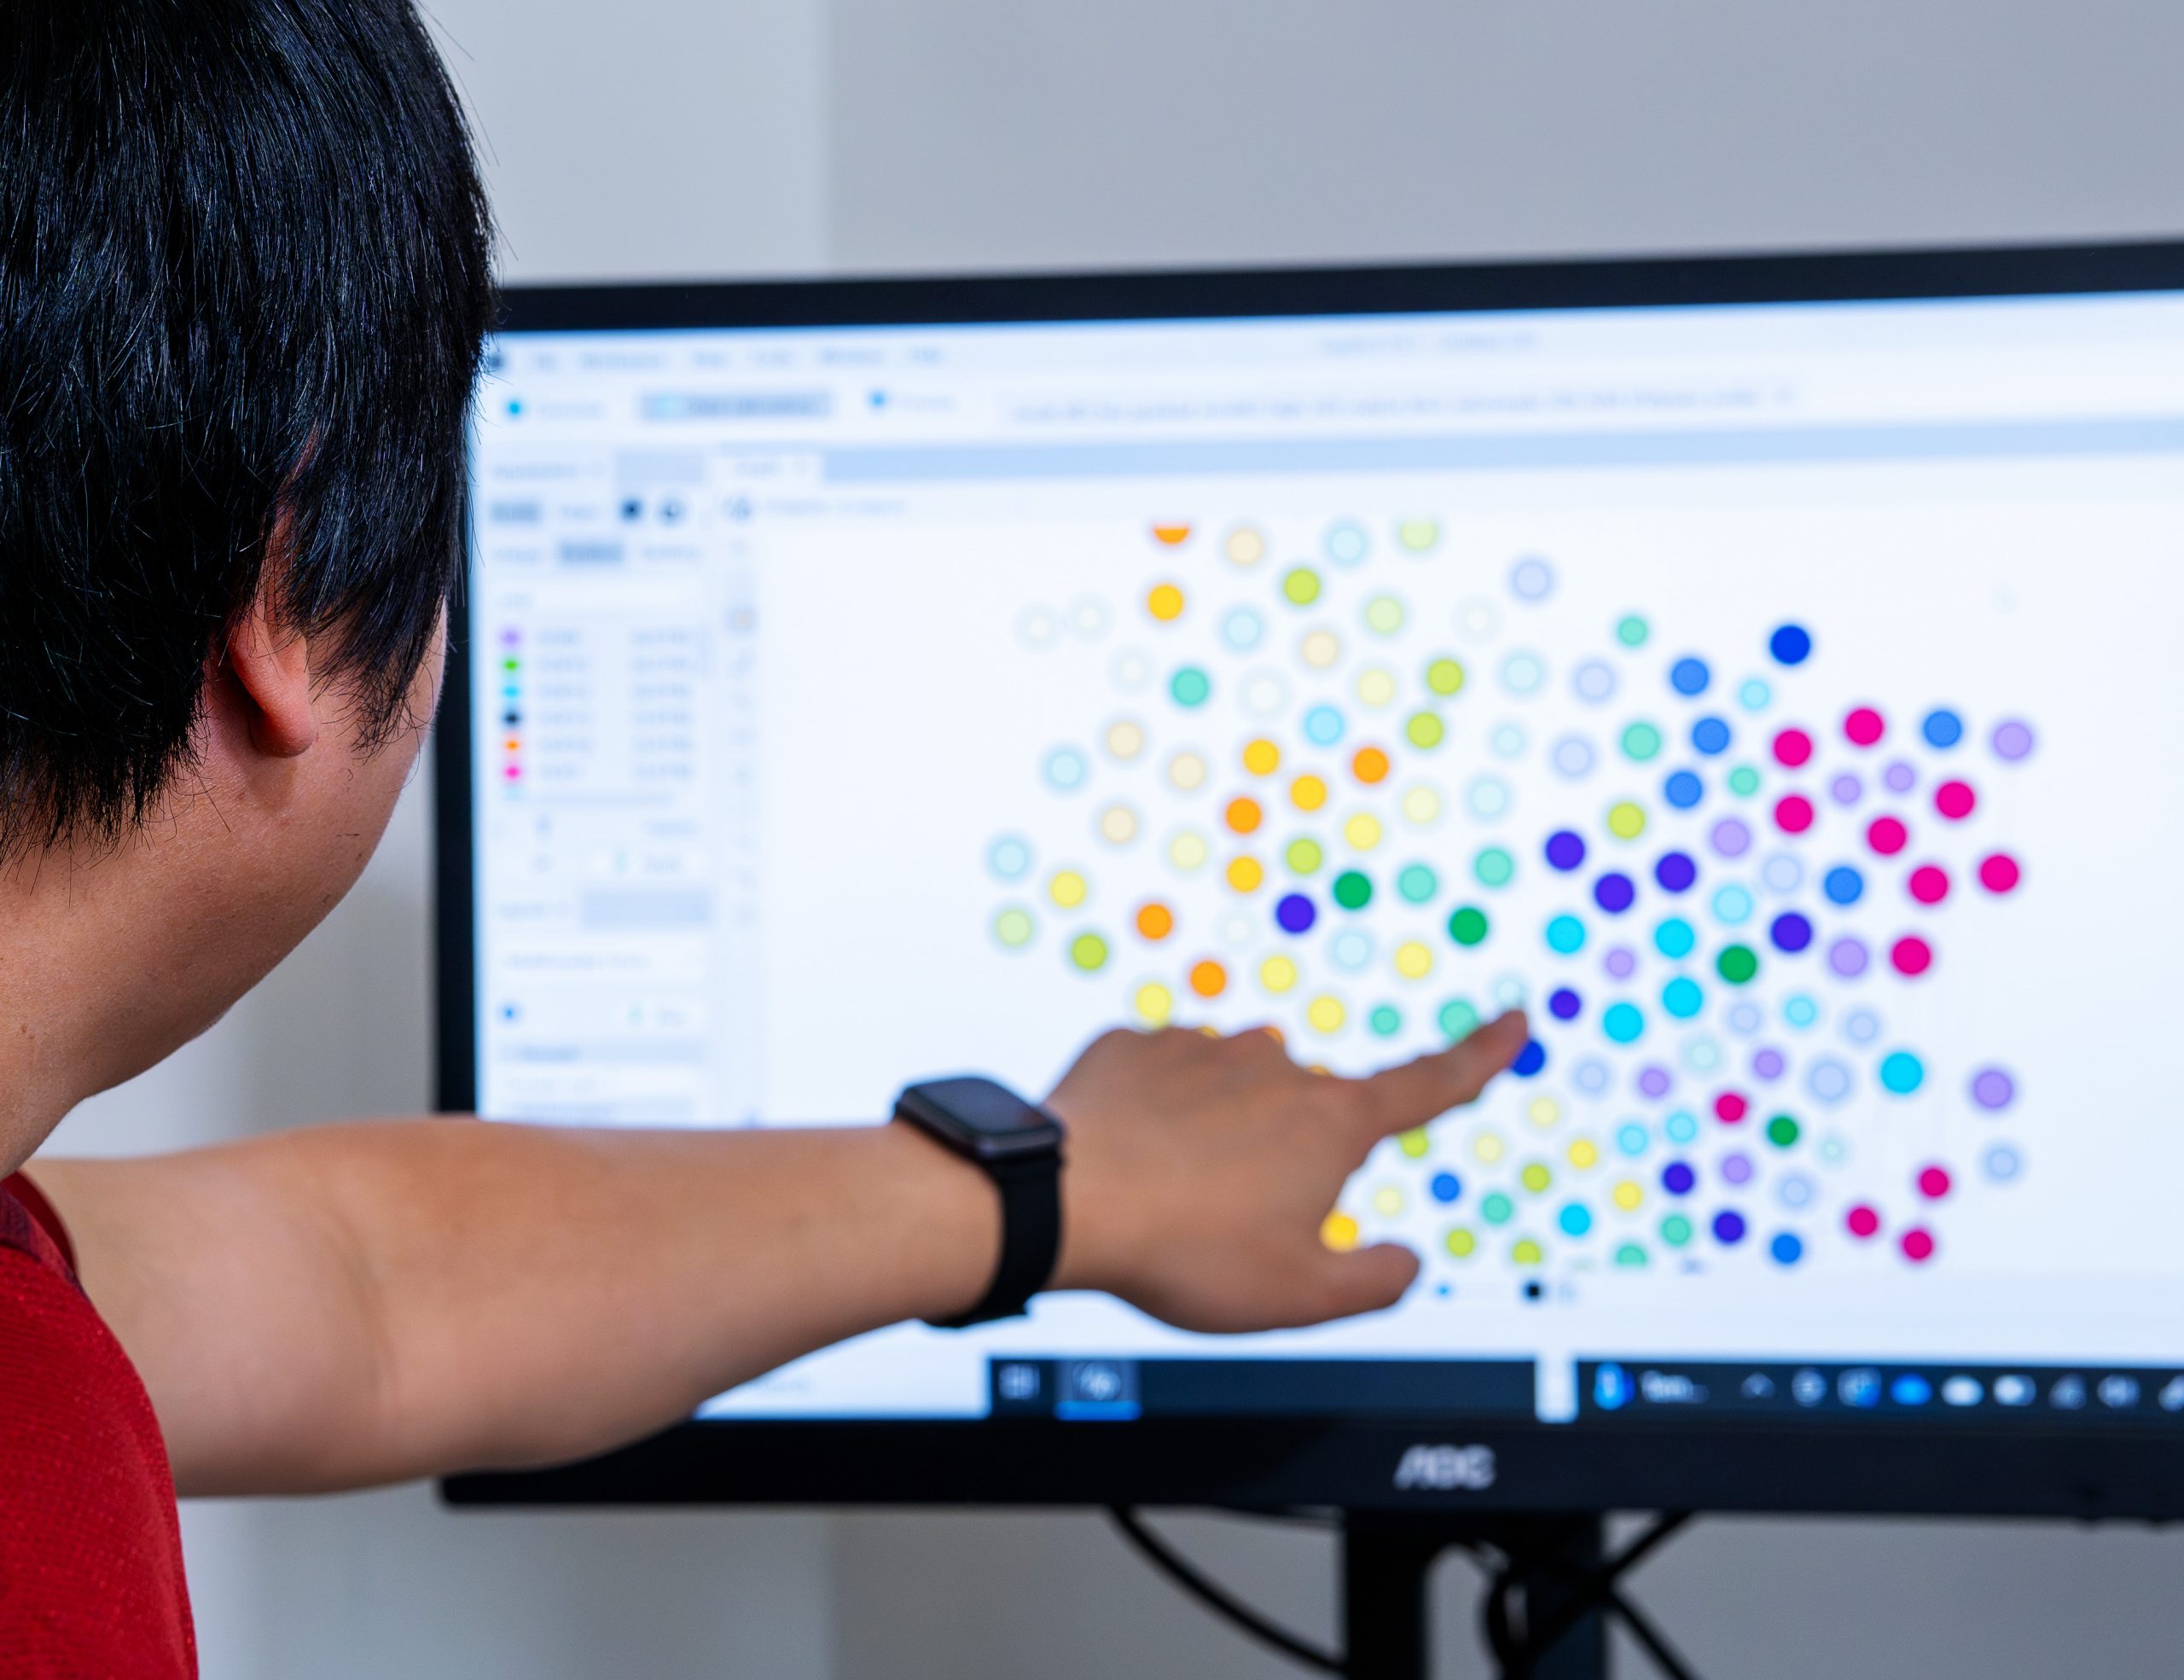
Pomocí prostorových simulací jsme zjistili, že řídké vzorkování v kombinaci se ztrátou vzácných genetických variant může zkreslit grafy PCA, což je nejběžnější vizualizační metoda. Mohou v nich vznikat například trojúhelníky, shluky ve tvaru písmene Y nebo umělé odlehlé hodnoty.
Pozorovatel by mohl takový trojúhelník interpretovat jako důkaz mísení tří různých populací předků. Ve skutečnosti ale může jít pouze o důsledek způsobu, jakým byla data nasbírána a následně smrštěna do dvou nebo tří dimenzí.
Proto se snažíme vyvíjet lepší způsoby vizualizace dat. Přesvědčivý obrázek je i tak teprve začátkem argumentace, nikoli jejím závěrem.
Výzkum starobylé DNA už dříve ukázal, že se před přibližně pěti tisíci lety lidé geneticky spříznění s pastevci jámové kultury rozšířili z pontsko-kaspické stepi jak na západ do Evropy, tak na východ napříč Eurasií. Tato migrace hluboce proměnila genetickou krajinu Evropy a byla velmi pravděpodobně spojena se šířením alespoň některých indoevropských jazyků.
Ukázali jsme například, že přibližně čtyři pětiny genetického původu lidí spojených s jámovou kulturou lze dohledat u populací žijících mezi Kavkazem a dolním tokem Volhy. Ty se rozšiřovaly na západ a mísily s místními lovci a sběrači v oblastech Dněpru a Donu.
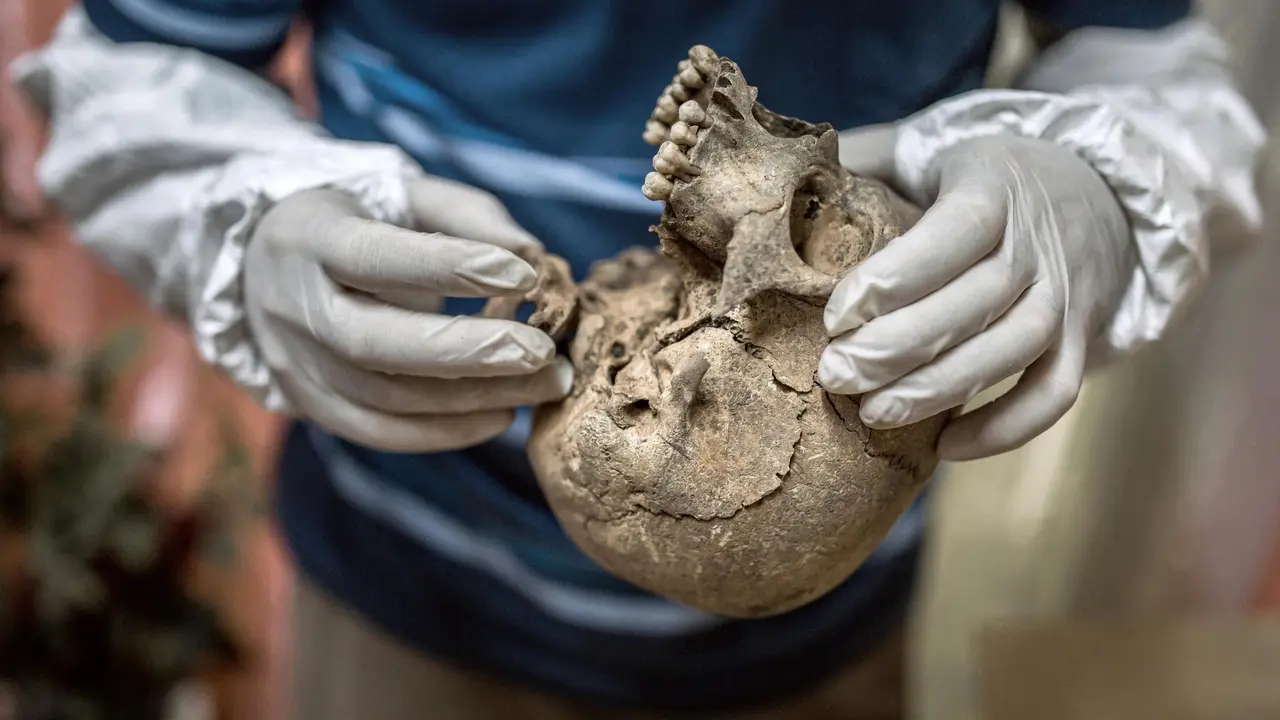
Ačkoliv genetická data nemohou přímo doložit, jakým jazykem konkrétní lidé mluvili, poskytují důležitá vodítka. Genetickou složku příbuznou těmto kavkazsko-dolnovolžským populacím jsme detekovali také v Anatolii v době bronzové, tedy v oblasti, kde se mluvilo chetitštinou – nejstarším doloženým indoevropským jazykem. Vzniká tak věrohodné genetické propojení mezi stepí a anatolskou větví indoevropských jazyků, které bylo předtím obtížné vysvětlit.
Vždycky mě bavil pravěk a snaha rekonstruovat historii a příbuznost jazyků prostřednictvím dějin lidských populací.
Postupem času jsem ale začal být vůči některým standardním metodám používaným v našem oboru skeptičtější. Dnes mě přitahuje aplikovaná matematika, která stojí za vývojem metod. Detaily lidských migrací mě samozřejmě pořád fascinují, ale čím dál více mě zajímá otázka, jak zajistit, aby nástroje, kterými minulost zkoumáme, skutečně fungovaly.
Mnohem více než konkrétní výzkumné objevy mě upřímně překvapily některé vědecké praktiky. Nečekal jsem, že v prestižních časopisech našeho oboru vyjde tolik prací založených na pochybných předpokladech nebo metodách, které nikdy neprošly dostatečným ověřením.
Právě proto jsme v rámci našeho projektu vypracovali doporučené postupy a obecné principy pro testování jednoduchých modelů mísení. Chceme přispět k tomu, aby byly metody používané v archeogenetice spolehlivější.
Je to první národní ocenění v mé kariéře, takže mě velmi překvapilo a potěšilo. Vnímám ho zároveň jako uznání pro celý obor archeogenetiky v České republice.
Na našem projektu si nejvíce cením naší vytrvalosti a smyslu pro detail – jak statistický, tak archeologický. Mám štěstí, že mám v týmu lidi, kteří to vidí podobně a pro které je kvalita důležitější než rychlost.
Jsem v Ostravě spokojený a rád bych tu zůstal. Mám tu výzkumnou skupinu, moje děti tu chodí do školy a zkrátka se mi nechce vytrhávat kořeny a stěhovat se jinam. Jinde jsou dnes jistě živější výzkumná prostředí. Ale upřímně řečeno, v dnešní době často získávám více poznatků z rozhovorů s nejmodernějšími modely AI než z rozhovorů s jinými vědci, kteří jsou nanejvýš zaneprázdnění a k tomu mají i svá ega.
Pokud mluvíme o větším snu, chtěl bych vybudovat systém, který nám pomůže zvládnout exponenciální nárůst dat v archeogenetice. Máme stále více dat, ale zatím nemáme dostatek metod, lidí ani infrastruktury, abychom tento růst dokázali dlouhodobě zvládnout. A problém není jen v samotných genomech; rozsáhlé databáze obsahují chyby nebo v nich chybějí archeologická metadata. Jedním z velkých úkolů archeogenetiky proto podle mě bude naučit se tento obrovský objem genetických a archeologických dat nejen zpracovávat, ale především mu správně rozumět.